如何教大型多模态模型新技能?
LLaVA、Qwen2.5-VL 这样的大型多模态模型(LMM)能用自然语言回答关于图像的问题,而且在非常广的范围内表现出色。但它们并非无所不能。让它数一数人群里有多少人、读一块指针式钟表、或者诊断一张病理切片,它往往会失败。从头训练一个新的 LMM 要花费数百万美元和数周的算力,所以现实的路径是微调手头已有的模型。问题在于,在单一的窄领域技能上直接微调,往往会侵蚀模型原本具备的广泛能力,也就是我们熟悉的灾难性遗忘。那么:如何教 LMM 学会新东西,又不让它忘掉旧本领?
我们的 ECCV 2026 论文把这个问题当真来回答。我们搭建了一个受控实验平台,在五项新技能的序列上微调三个系列的 LMM,并全程观察八个通用基准的变化。有两个发现出乎我们的意料,而追问其中的原因又引出了两个极其简单的训练配方:它们的学习效果几乎与全量微调相当,却几乎不产生任何遗忘。
两个意外
我们最初的实验只是在问:梯度应该落在模型的哪里。一个 LMM 由三部分组成:把图像变成 token 的视觉编码器、把这些 token 映射到语言模型维度的投影层,以及一个 decoder-only 的语言模型。语言模型的每个 transformer 块内部又有两个子块:自注意力投影(query、key、value 和 output 矩阵,我们称之为 SA Proj.)和前馈 MLP。我们在五个目标任务的序列上,分别单独微调这些组件,以及整个模型。
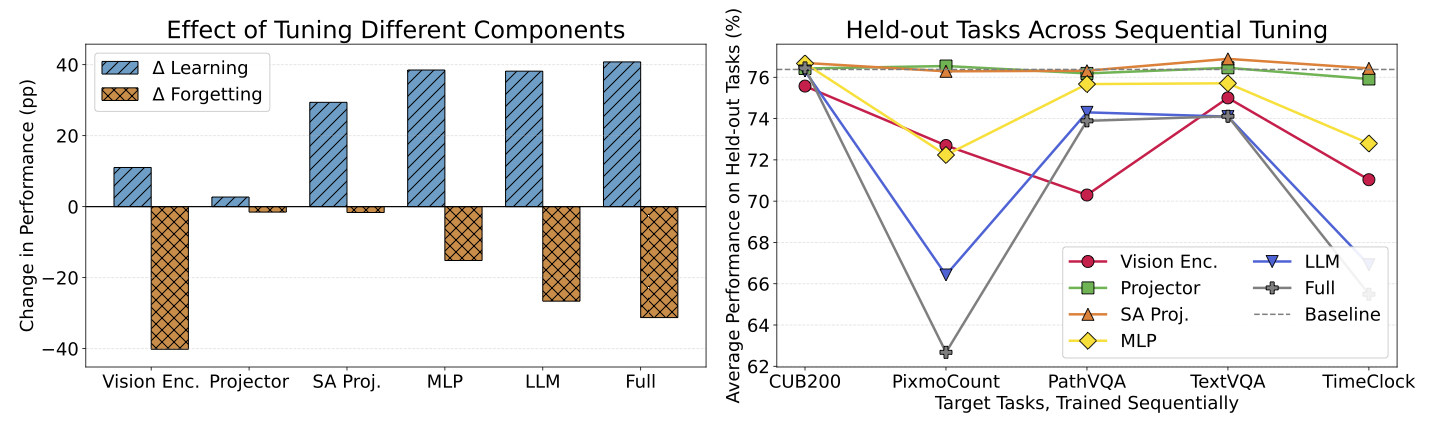
第一个意外就在上面的题图里。只微调自注意力投影,对目标任务的学习效果几乎与微调整个语言模型相当,而在整个五任务序列中,它在留出基准上的准确率几乎纹丝不动。在不使用重放、模型扩展或强正则化的情况下还能做到强学习、零遗忘,我们没有见过其他先例。
第二个意外是其余曲线的形状。随着学到的任务越来越多,留出性能并不是单调下降的。它在计数任务(PixmoCount)之后崩塌,随后在训练下一个任务——医学 VQA——之后大幅恢复,而这个任务与那些丢失的基准毫无关系。全模型微调时,留出平均分从 76 跌到 63,又爬回 74。那些被『遗忘』的东西显然并没有真正消失。
实验平台
为了严谨地研究这一现象,我们需要一个能把学习和遗忘放在同等地位上衡量的协议。我们选择了五项在实际应用中常见、而 LMM 通常表现不佳的目标技能,每项的答案格式各不相同:细粒度鸟类分类(CUB-200)、计数(PixmoCount)、医学 VQA(PathVQA)、OCR 阅读(TextVQA)和指针式钟表读数(TimeClock)。它们合计约 108K 条训练样本。模型在这些任务上依次微调,不重放之前的任务,并在每个阶段之后同时评测目标任务和八个覆盖广泛视觉—语言能力的留出基准:AI2D、ChartQA、DocVQA、InfoVQA、RealWorldQA、SeedBench、ScienceQA 和 MMStar。
由此我们为每种方法计算四个指标,均以相对基座模型的百分点变化表示:目标学习(每个任务在被训练时提升了多少)、目标遗忘(序列结束时先前的目标任务下降了多少)、目标总体(序列结束时所有目标任务的净变化)和留出遗忘(序列结束时留出平均分的变化)。LLaVA-OneVision 上的主要结果取三种不同任务顺序的平均值。
微调哪里
| 微调组件 | 目标学习 ↑ | 目标遗忘 ↑ | 目标总体 ↑ | 留出遗忘 ↑ |
|---|---|---|---|---|
| 全模型 | +29.9 | −25.9 | +9.2 | −27.4 |
| 视觉编码器 | +9.6 | −12.7 | −0.5 | −10.8 |
| 投影层 | +2.3 | −0.8 | +1.7 | −1.3 |
| LLM | +31.8 | −23.5 | +13.0 | −23.3 |
| SA Proj. | +24.9 | −2.3 | +23.1 | −0.6 |
| SA Proj.(仅 QKV) | +14.9 | −0.5 | +14.5 | +0.2 |
| MLP | +31.1 | −19.5 | +15.5 | −15.7 |
| MLP (Gate & Up) | +30.5 | −4.2 | +27.1 | −2.1 |
LLaVA-OneVision,相对基座模型的百分点变化(目标任务基线 43.9,留出基准基线 76.4),取三种五任务顺序的平均值。
几个规律一目了然。学习发生在语言模型里:微调 LLM 带来最强的提升,而微调视觉编码器学得很少、还会损害通用能力,投影层则几乎不起作用。但全量微调 LLM 的遗忘也最严重。打开 LLM 来看,两个子块的表现截然不同。微调 MLP 的学习效果与整个 LLM 相当,遗忘略少一些。微调自注意力投影学得稍少,却几乎完全不遗忘。
最后一行是我们最终最常推荐的做法。这些模型中的 MLP 计算 W_down(SiLU(x W_gate) ⊙ (x W_up))。如果我们微调 gate 和 up 矩阵、冻结 down 投影,就能保留全量微调 MLP 的几乎全部学习能力(+30.5 对 +31.1),同时把留出遗忘从 −15.7 压到 −2.1,并在序列结束时取得所有方法中最高的目标任务得分。
原因:遗忘是输出分布偏移
为什么自注意力投影如此稳健,而 MLP 的 down 投影又如此关键?对 transformer 的机制研究给出了一种分工图景。注意力头主要负责路由:决定从上下文的哪里读取信息,并混合相应的值。MLP 则表现得像键—值记忆:gate 和 up 矩阵检测输入模式,down 投影把与成组词表 token 对齐的特征写回残差流,直接塑造下一个 token 的分布。
这启发了一个假说。当你在一个所有答案都长得差不多的窄任务上微调时(每个计数答案都是『There are N …』),模型有一条捷径可走:与其学会更好地计数,不如直接把输出分布偏向数字 token。而写回路径——尤其是 MLP 的 down 投影——正是安置这种偏置的地方。如果我们测到的遗忘有很大一部分其实是这种应答偏置,那么:(a) 把更新限制在路由(SA Proj.)或特征检测(MLP gate 和 up)上应当能抑制它;(b) 在一个答案格式不同的后续任务上训练应当能消除它,这正是我们看到的恢复现象。
为了验证这一点,我们设计了一个计数偏置探针。取一批固定的普通图像描述图片,让模型用贪心解码生成描述,并在每个解码位置记录模型赋予任何数字 token 的最大概率。对所有位置和图片取平均后,这个数字告诉我们:在没有任何理由的情况下,模型被拉向说出数字的倾向有多强。
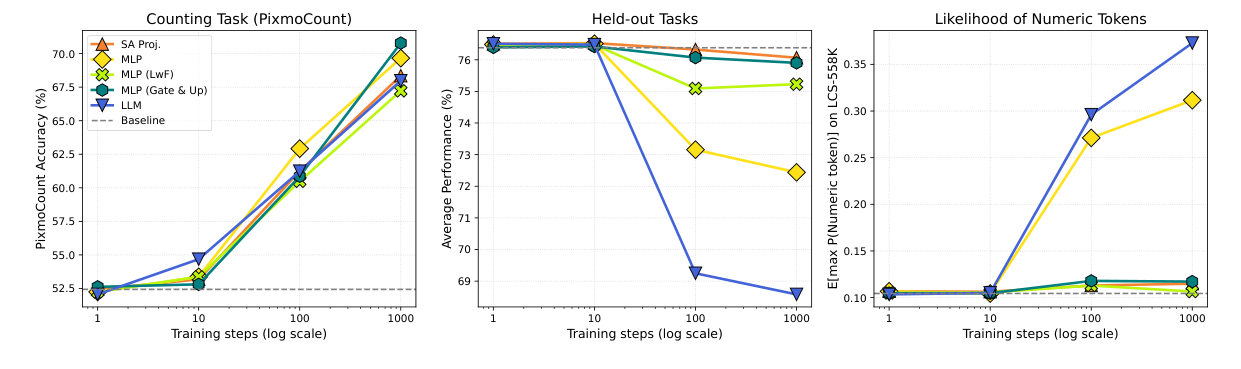
这个探针与遗忘的共变程度惊人:跨训练步数和跨方法来看,数字 token 概率与留出基准跌幅之间的 Spearman 相关系数达到 0.84。全量微调 LLM 和全量微调 MLP 都学会了计数,也都开始往图像描述里乱塞数字。SA Proj. 和 MLP (Gate & Up) 学会了计数,却没有这种副作用。附录中的逐层分析把诱发的 logit 偏移大部分归因于 MLP 块;把探针扩展到三个连续阶段后可以看到,数字偏置在学习计数时陡增、在学习下一个任务时消退,与留出准确率的下跌和恢复步调完全一致。
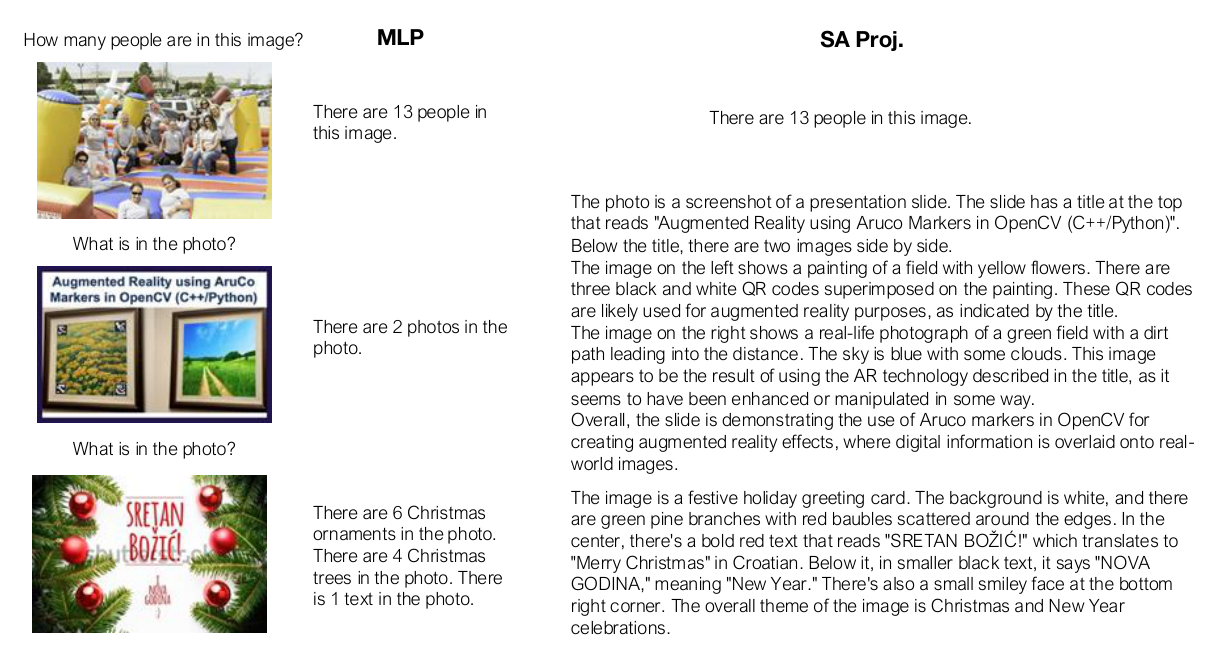
定性的表现也很能说明问题。在 PixmoCount 上训练计数 1K 步之后,微调 MLP 和微调 SA Proj. 的模型都能正确回答计数问题。但如果问微调 MLP 的模型一张照片里有什么,它会回答『There are 2 photos in the photo.』。视觉理解其实完好无损——它仍然认得出物体和关系——只是输出被重新框定成了一句计数陈述。而微调 SA Proj. 的模型仍然能写出一段细致的描述。
两个配方
这就给标题中的问题一个明确的答案。要教 LMM 一项新技能而不遗忘,就把更新限制在那些不直接写入输出分布的组件上:
- SA Proj.:微调每个注意力块的 query、key、value 和 output 投影,冻结其余所有参数。当通用基准上的稳定性最重要时,优先选它。
- MLP (Gate & Up):微调每个 MLP 块的 gate 和 up 投影,冻结 down 投影。当你想在有限遗忘下获得接近最大的学习效果时,优先选它。
两者都只需在任何现有训练脚本上加几行代码:
for p in model.parameters():
    p.requires_grad = False

# Recipe 1: self-attention projections only
sa_keys = ("self_attn.q_proj", "self_attn.k_proj", "self_attn.v_proj", "self_attn.o_proj")
for name, p in model.named_parameters():
    if any(k in name for k in sa_keys):
        p.requires_grad = True

# Recipe 2 (alternative): MLP gate & up only, down projection stays frozen
for name, p in model.named_parameters():
    if "mlp.gate_proj" in name or "mlp.up_proj" in name:
        p.requires_grad = True
不需要额外模块,不需要重放缓冲区,不需要逐阶段调整超参数,也不需要额外的前向计算。在四张 H100 GPU 上,SA Proj. 微调的速度是每秒 1.46 个样本,快于 LoRA(1.27),更远快于一种混合专家变体(0.44),因为计算图中没有任何适配器或路由器。
换个模型还成立吗?
我们在 LLaVA-NeXT(LLaMA-3 8B)和 Qwen2.5-VL(7B)上重复了这套五任务课程。数字有所不同,但结论没有变。
| 微调组件 | LLaVA-NeXT:目标总体 ↑ | LLaVA-NeXT:留出 ↑ | Qwen2.5-VL:目标总体 ↑ | Qwen2.5-VL:留出 ↑ |
|---|---|---|---|---|
| 全模型 | +15.4 | −32.0 | +13.1 | −17.5 |
| 视觉编码器 + 投影层 | −1.3 | −13.4 | +4.9 | −6.2 |
| LLM | +19.3 | −35.9 | +12.1 | −24.6 |
| SA Proj. | +21.9 | −7.7 | +14.9 | +0.6 |
| MLP | +26.6 | −16.3 | +13.9 | −10.9 |
| MLP (Gate & Up) | +20.9 | −8.7 | +17.1 | −4.6 |
完整五任务序列结束后相对各自基座模型的百分点变化。
LLaVA-NeXT 总体上更容易遗忘,但 SA Proj. 和 MLP (Gate & Up) 的遗忘仍不到全量微调 MLP 的一半、不到全量微调 LLM 的四分之一。在 Qwen2.5-VL 上,SA Proj. 甚至对留出基准表现出轻微的正迁移,而 MLP (Gate & Up) 取得了最佳的目标总体得分,目标遗忘几乎为零。它的绝对增益看起来较小,只是因为其基座模型的起点高得多。
与常见缓解手段的比较
选择性微调并不是限制遗忘的唯一办法,所以我们还在 MLP 层上测试了持续学习的几大标准支柱:Learning without Forgetting(相对上一阶段模型的 KL 蒸馏损失)、LoRA、混合专家扩展,以及 WiSE-FT 权重插值。
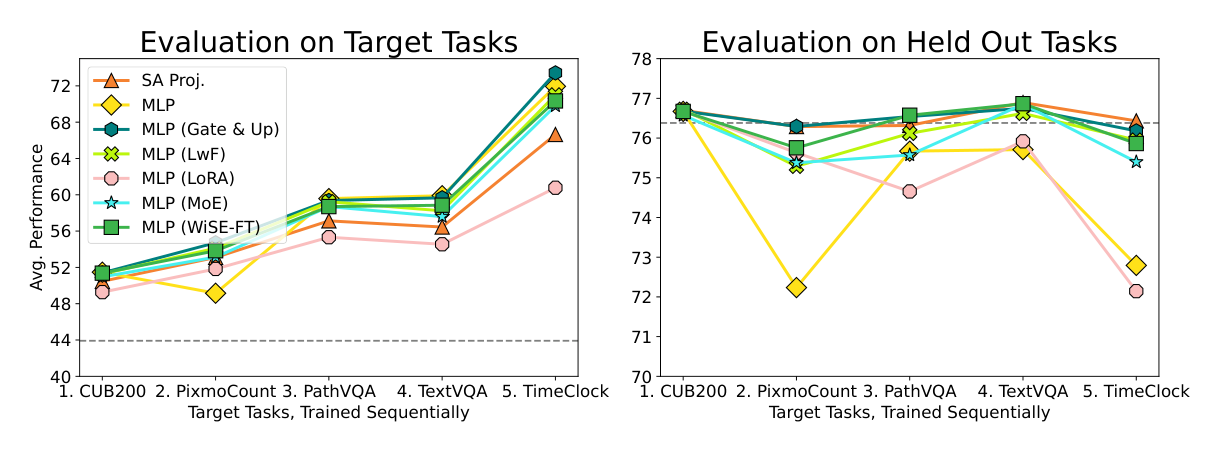
蒸馏确实能可靠地抑制遗忘,这与输出偏移的解释吻合——它惩罚的正是这种偏移——但可能以目标性能为代价。WiSE-FT 能很好地保住留出准确率,却需要为每个阶段选取依赖任务的插值系数。LoRA 学得明显更少,而混合专家在学习和保持两方面都不如这两个简单配方。在学习—稳定性的权衡上,SA Proj. 和 MLP (Gate & Up) 追平或超越了所有这些方法,同时是桌面上最简单的选项。
局限
我们的研究覆盖 7B 到 8B 的开源模型。我们尚未验证同样的配方是否适用于更大规模或商用的 LMM,也未验证当适配数据扩展到数十亿样本时是否依然成立。在用 iNaturalist 分类这类规模极大的长尾任务持续加压时,我们确实观察到了少量遗忘,所以『不遗忘』应当理解为『在现实的技能适配负载下遗忘极少』,而不是一种保证。
延伸阅读
论文以 spotlight 形式发表于 ECCV 2026。代码包含完整的评测套件(通过 lmms-eval 评测五个目标任务和八个留出基准)、逐组件微调脚本、计数偏置探针,以及 LwF、LoRA、MoE 和 WiSE-FT 基线的参考实现。
@inproceedings{zhu2026teach,
  title     = {How To Teach Large Multimodal Models New Skills?},
  author    = {Zhen Zhu and Yiming Gong and Yao Xiao and Yaoyao Liu and Derek Hoiem},
  booktitle = {European Conference on Computer Vision (ECCV)},
  year      = {2026}
}
本工作部分受 ONR 基金 N00014-23-1-2383 和美国 DARPA ECOLE 项目(HR00112390060)资助。GPU 由 NCSA Delta 通过 ACCESS 配额 CIS230397 提供。