FreeOrbit4D:无需训练,从任意相机视角重放单段视频
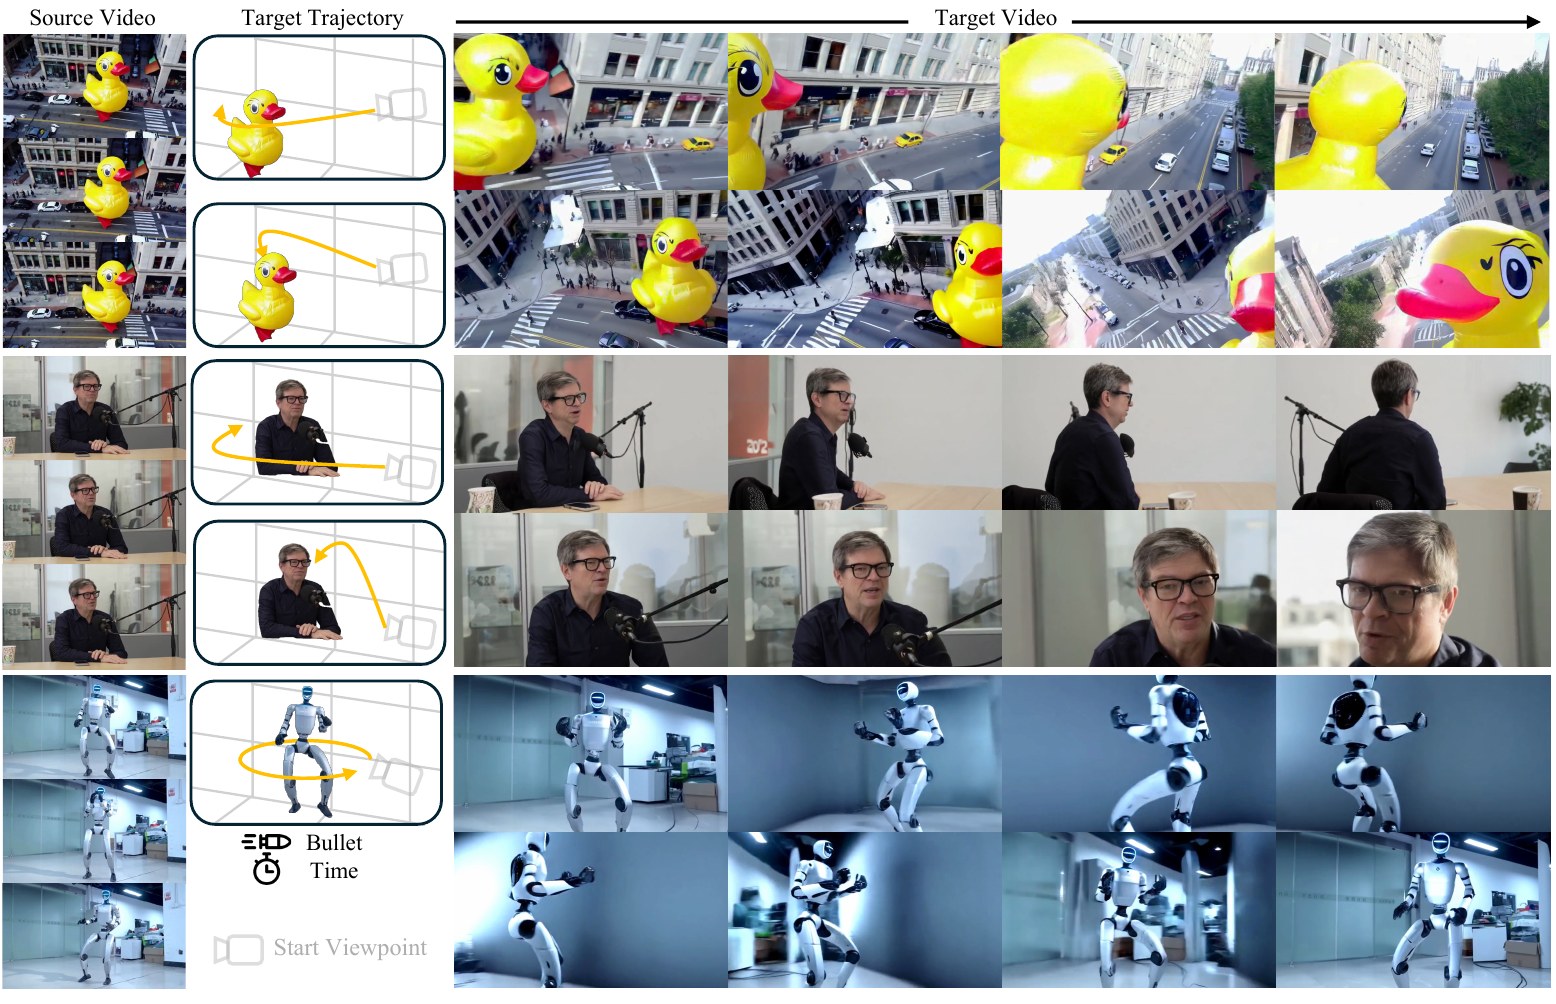
每一段手机视频都只从一个视角拍摄。然而当我们观看一段采访视频时,却可以毫不费力地想象同一时刻从侧面、背面或上方看去的样子:我们在脑中构建出一个粗略的三维世界,并从任意位置重放其中的运动。相机重定向(camera redirection)要求机器做到同样的事情:仅凭一段单目视频,沿用户指定的相机轨迹合成动态场景的新视频。如今,子弹时间回放等特效仍然依赖多相机阵列;若能从一段随手拍摄的视频做到这一点,这种能力就会进入每个人的口袋。
我们很高兴分享 FreeOrbit4D,这是我们在 SIGGRAPH 2026 上针对该问题发表的论文。FreeOrbit4D 是免训练的:它直接组合现成模型而无需任何微调,并且能够应对现有方法失效的场景,即大角度重定向——目标相机偏离原拍摄位置 120° 甚至 180°。其核心思想是首先恢复一个前景完整的 4D 代理表示,即场景的显式点云表示,其中运动物体在所有方向上都被重建出来,包括相机从未看到的那些面;随后将该代理表示作为几何支架,交给视频扩散模型使用。
为什么大角度重定向如此困难
一段单目视频只是 4D 世界中极薄的一个切片。它只能从单一方向观察每个表面,背对相机的部分根本不会被记录。对于小幅度的视角变化,可以通过重建可见表面并重新渲染来处理,NeRF 和高斯泼溅(3D Gaussian Splatting)类方法正是这样做的。但一旦目标相机远离源相机轨迹,画面中便以未被观测到的表面为主,而输入中没有任何信息可以支撑它们。
近期的工作借助视频扩散模型来填补这一空缺,大体遵循两种思路。隐式控制方法将目标相机编码为学习得到的嵌入或文本提示,并注入生成器。这只能提供软性可控性:文本无法描述一条精确的环绕轨迹,学习到的条件经常忽略所要求的路径(”转到背面”的指令常常并不会转到背面),而且训练这类模型需要成对的多视角视频数据,获取成本高且稀缺。显式变形方法则估计深度,将观测到的像素变形到目标视角,再让生成器修补空洞。此时相机控制变得精确,但变形后的几何只包含曾经可见的内容,物体到达新视角时缺失了一半,生成器不得不逐帧凭空补全其余部分,且没有任何 3D 支撑来保证时间一致性。
两种思路都无法同时提供精确的相机控制和对未见区域的完整覆盖,而忠实的大角度重定向这两者缺一不可。
前景完整的 4D 代理表示
我们的观察是:从单目视频重建动态场景,与补全物体被遮挡的几何,本质上是两个不同的任务。前者需要时间一致的、场景级的推理;后者需要对物体形状的多视角理解。因此,我们在不同的坐标空间中分别处理这两个任务,各自使用擅长的模型,最后再将结果统一起来。
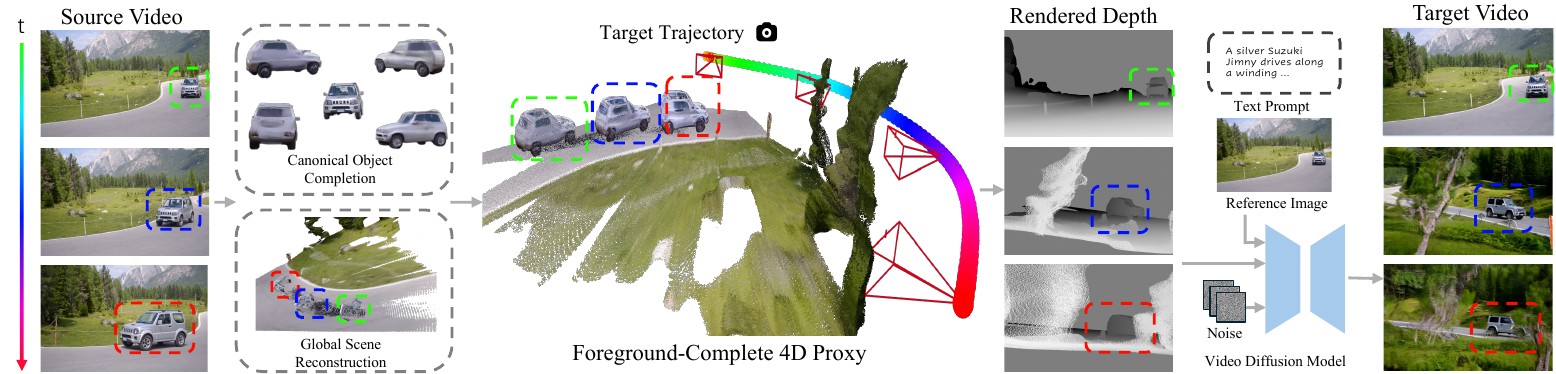
解耦的 4D 重建。在全局场景空间中,一个感知动态的前馈网络(PAGE-4D,即 VGGT 的时间感知扩展版本)将源视频的每一帧提升为配准在同一世界坐标系下的点图。SAM 2 的掩码——通过在第一帧点击一次或由检测器自动生成——将这些点划分为静态背景和逐帧前景。该前景在几何上是不完整的:它只包含源相机看到过的表面。与此同时,在规范物体空间中,我们将前景从每一帧中裁剪出来,并将序列输入一个以物体为中心的多视角视频扩散模型(SV4D 2.0),它会合成四个时间同步的新视角,方位角间隔 90°。对源视角加上这四个合成视角运行 VGGT,便能为每一帧获得完整的前景点云,但这个点云完全不知道物体在场景中的位置。
对应感知的对齐。两个前景必须合并,而让这一步变得容易的关键在于:二者都源自同一张源图像。第 t 帧中的一个像素既对应不完整点云中的一个 3D 点,也对应完整点云中的一个 3D 点,因此我们免费获得了稠密的、像素级同步的 3D–3D 对应关系。单目提升无法确定绝对深度尺度,所以我们并不逐点拟合两个点云;而是仅用不完整点云来确定物体的位置和大小,逐帧估计尺度和平移,同时保持完整点云的几何不变。由于单目深度还会逐帧抖动,我们在匀速运动模型下用双向 Kalman 滤波器平滑对齐后物体的质心轨迹。最终输出就是前景完整的 4D 代理表示:静态背景,加上每个时间步都完整、位置正确、时间上连贯的前景。
几何条件化的视频合成。最后,我们沿目标相机轨迹将代理表示渲染为逐帧深度图,交给一个以深度为条件的视频扩散模型(Wan2.2-VACE),同时提供源视频第一帧作为外观参考以及一个文本提示。深度并非完整的几何信息,但它紧凑地编码了目标视角下的 3D 布局与可见性,而这正是生成器精确遵循指定相机轨迹并保持帧间一致所需要的。整条流水线可在单张 NVIDIA A40 上运行,处理一段 832×480、45 帧的片段约需 50 分钟。
实验结果
多个场景的可交互 4D 点云,包括下方的机器人演示,都可以在项目主页上旋转查看并沿时间轴拖动。
由于代理表示是真正的 3D 表示,同一次重建可以沿任意多条轨迹重放。下方每段输入视频都被重定向到两个不同的目标相机。
测试场景涵盖关节式人体运动、人形机器人、动物和车辆,既有来自 DAVIS 和网络视频的真实素材,也有由 Veo 和 Sora 生成的合成片段。在评测中,我们特意选择极端轨迹,即相对初始视角偏航或俯仰旋转 120° 或 180°。
我们与五种近期的相机可控视频到视频方法进行了比较:ReCamMaster、TrajectoryCrafter、EX-4D、GEN3C 和 CogNVS。下方的”Swing”序列是一个困难案例:前景运动剧烈,秋千绳索纤细,而相机要围绕场景环绕 120°。ReCamMaster 和 EX-4D 丢失了人体结构,产生模糊的肢体和重影;TrajectoryCrafter、GEN3C 和 CogNVS 则随着相机旋转出现几何和语义上的漂移。FreeOrbit4D 自始至终保持清晰的细节和稳定的几何,因为补全后的前景告诉了生成器那里应当是什么。
在定量评测中,FreeOrbit4D 在 VBench 六个维度中的五个上排名第一,并在所有方法中取得最优的 DINO-SIM、CLIP-SIM 和 FID-V。但我们发现,自动指标并不能真正衡量方法是否遵循了相机轨迹:ReCamMaster 和 TrajectoryCrafter 得分尚可,却明显偏离了所要求的路径。因此我们还开展了一项用户研究,由 20 名参与者对 10 个序列按 1–5 分评价总体偏好、相机运动准确性和时间稳定性。在用户研究中,差距要大得多。
| 方法 | DINO-SIM ↑ | CLIP-SIM ↑ | FID-V ↓ | 总体 ↑ | 相机运动 ↑ | 稳定性 ↑ |
|---|---|---|---|---|---|---|
| ReCamMaster | 0.37 | 0.75 | 2.6 | 2.0 | 2.5 | 2.0 |
| TrajectoryCrafter | 0.47 | 0.79 | 2.0 | 2.8 | 3.2 | 2.9 |
| EX-4D | 0.28 | 0.69 | 3.2 | 2.0 | 2.5 | 2.0 |
| GEN3C | 0.43 | 0.75 | 2.3 | 2.4 | 3.5 | 2.3 |
| CogNVS | 0.34 | 0.78 | 3.0 | 2.0 | 3.2 | 1.9 |
| FreeOrbit4D | 0.65 | 0.84 | 1.7 | 4.6 | 4.5 | 4.5 |
FID-V 以 ×10² 报告。右侧三列为用户研究评分(1–5 分)。完整的 VBench 和 FVD-V 数据请参见论文。
消融实验证实了设计中两个部分的必要性。若简单地将合成的多视角图像与源视频一起输入单个前馈重建器,时间维度上的对应关系会坍塌并产生重影;去掉多视角生成会使所有指标下降;去掉 Kalman 平滑则会明显损害连贯性。
不止于重定向
由于代理表示是显式、可编辑的点云,而非网络内部的隐变量,它的用途不止于移动相机。
外观传播。用图像编辑器(我们使用 Qwen-Image-Edit)编辑单张参考帧,比如给汽车加上斑马纹,或转换为动漫风格,代理表示的深度支架就能将这一编辑一致地传播到重定向视频的每一个新视角。
4D 几何操控。点云可以直接在时空中编辑:缩放前景,或将从不同视频重建出的物体合成到同一个共享场景中,然后基于修改后的几何合成一段合理的重定向视频。我们认为这指向了利用重建出的代理表示进行 4D 资产创建和合成数据生成的方向——在那里,稠密、一致的几何和标注是免费附带的。
局限性
FreeOrbit4D 假设场景中存在单个主要前景物体,且背景基本静态。只要每个物体在时间上都被充分观测到,它也能处理多个物体,但严重的相互遮挡或动态背景对当前以物体为中心的模型来说仍然困难。作为由现成组件搭建的模块化系统,分割或多视角合成等上游环节的错误会向下游传播,不过这种模块化也意味着每个组件都可以在更强的替代品出现时被随时替换。此外,这条多阶段流水线以质量优先而非速度优先;每段视频需要数十分钟,尚无法做到交互式。
延伸阅读
论文收录于 SIGGRAPH 2026 Conference Papers。项目主页提供可旋转、可沿时间轴拖动的交互式 4D 重建结果,以及所有序列的完整对比;代码已在 GitHub 开源。
@inproceedings{cao2026freeorbit4d,
  title     = {{FreeOrbit4D}: Training-Free Arbitrary Camera Redirection for Monocular Videos via Foreground-Complete {4D} Reconstruction},
  author    = {Wei Cao and Hao Zhang and Fengrui Tian and Yulun Wu and Yingying Li and Shenlong Wang and Ning Yu and Yaoyao Liu},
  booktitle = {SIGGRAPH Conference Papers},
  year      = {2026},
  url       = {https://doi.org/10.1145/3799902.3811122}
}
本研究得到美国国家人工智能研究资源(NAIRR)试点项目资助(项目编号 NAIRR250199),计算资源由 NCSA 的 Delta 与 DeltaAI 通过 ACCESS 分配提供。